Claude Opus 5.5: Fable-Niveau für 40 Prozent weniger
Anthropic bringt Opus 5.5: Leistung auf Höhe von Fable 5.1, rund 40 Prozent günstiger als Opus 5. Was das für Coding, Agenten und bestehende Integrationen heißt.
Anthropic hat Claude Opus 5.5 veröffentlicht, das erste Modell der neuen 5.5-Familie. Die Ansage ist kurz: Opus 5.5 soll bei den meisten Aufgaben auf dem Niveau von Claude Fable 5.1 arbeiten und rund 40 Prozent weniger kosten als Opus 5. Sonnet 5.5 und Haiku 5.5 sollen in den kommenden Wochen folgen. Die offizielle Ankündigung steht bei Anthropic.
Die Schlagzeile ist der Preis, und das zu Recht. Fable 5.1 war bisher das Modell für die wirklich schweren Läufe, und das sah man auf der Rechnung. Wenn die Opus-Klasse jetzt dort ankommt und dabei billiger wird als ihr eigener Vorgänger, verschieben sich die Kosten in fast jedem agentischen Setup. Die Benchmarks dagegen sollte man mit dem Hinweis lesen, den Anthropic selbst darunter schreibt.
Die Zahlen, und was Anthropic selbst davon hält
Auf dem Papier liegt Opus 5.5 in den meisten Disziplinen vorn. Beim agentischen Arbeiten im Terminal (Terminal-Bench 4.0) kommt es auf 66,4 Prozent. Fable 5.1 schafft 55,8, Opus 5 52,3. Bei praktischer Wissensarbeit über 44 Berufe (GDPval-AA) erreicht Opus 5.5 einen Elo-Wert von 1846, vor Fable 5.1 mit 1735 und Opus 5 mit 1708. Bei der Computernutzung (OSWorld 2.0) sind es 81,8 Prozent.
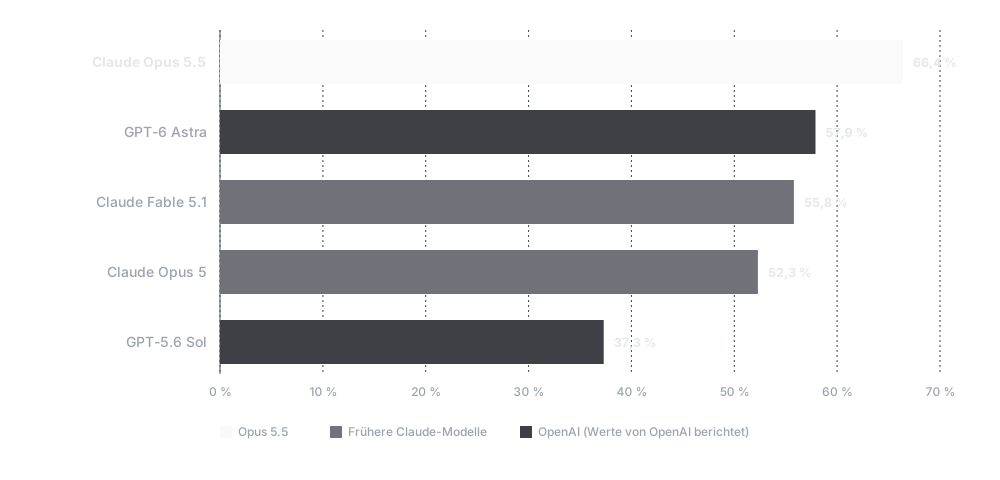
Alle Werte stammen von Anthropic, die Zahlen für GPT-6 Astra und GPT-5.6 Sol hat OpenAI selbst berichtet. Nachgemessen hat das bisher niemand Unabhängiges. Es gibt auch Stellen, an denen Opus 5.5 nicht gewinnt. Bei Geschäftsabläufen (AutomationBench, gemessen von Zapier) liegt GPT-6 Astra mit 41,4 knapp vor Opus 5.5 mit 40,0. Bei agentischer Forschungsarbeit in der Wissenschaft (Terminal-Bench-Science) ist der Abstand größer: 64,6 für Astra, 58,7 für Opus 5.5.
Unter die Tabelle schreibt Anthropic einen Satz, den man von Herstellern selten liest. Auf diesem Leistungsniveau seien Benchmark-Abstände ein immer schlechterer Hinweis auf echte Unterschiede, und im eigenen Einsatz sei der Abstand zu Fable 5.1 kleiner, als die Zahlen vermuten lassen. Wir lesen das so: Opus 5.5 ist nicht klüger als Fable 5.1. Es ist ungefähr gleich gut und deutlich billiger, und das reicht.
Preis und Tempo
Opus 5.5 kostet 4 $ pro 1 Mio. Input-Token und 20 $ pro 1 Mio. Output-Token, je 20 Prozent weniger als Opus 5 (5 $ und 25 $). Cache-Schreibvorgänge sinken von 6,25 $ auf 5 $.
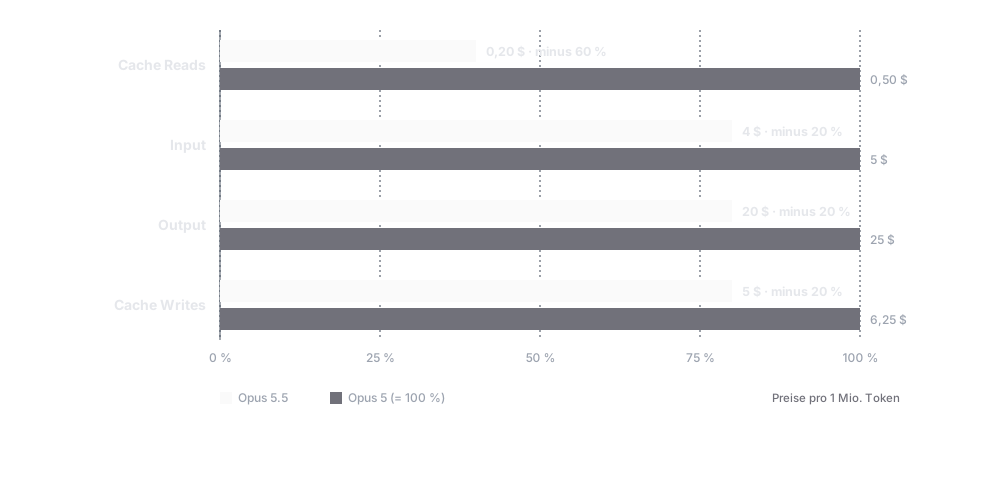
Die Zeile, die in der Praxis am meisten ausmacht, ist der Cache. Gelesene Cache-Token kosten 0,20 $ statt 0,50 $, also 60 Prozent weniger. Laut Anthropic machen sie bei agentischer Arbeit und beim Coding den Großteil der Kosten aus. Das ist plausibel: Ein Agent, der eine Stunde in einem Repository arbeitet, liest denselben Kontext wieder und wieder. Dazu braucht Opus 5.5 für dieselbe Aufgabe weniger Token. Zusammen ergibt das die rund 40 Prozent, die Anthropic nennt.
Schneller ist es auch. Die Ausgabe soll über 30 Prozent flotter laufen als bei Opus 5. In Claude Code und auf der Claude-Plattform gibt es zusätzlich einen Fast Mode mit bis zu 2,5-facher Geschwindigkeit, zum doppelten Preis von 8 $ und 40 $. Für Abo-Kunden hebt Anthropic die Fünf-Stunden-Limits in Pro, Max und Team an und verteilt einmalig einen Rate-Limit-Reset, den man aufheben und einsetzen kann, wenn es eng wird.
Was die Praxisbeispiele zeigen
Anthropic legt ein paar Fälle aus dem Early Access dazu, und die sagen mehr als die Tabelle. Ein Tester hat eine Codebasis mit 200.000 Zeilen in unter drei Stunden prüfen und bereinigen lassen. Opus 5 brauchte dafür über 20 Stunden und 2,5-mal so viele Token. Ein anderer hat eine Migration von 680.000 Zeilen in weniger als einem Tag durchgezogen.
Intern ließ Anthropic Opus 5.5 und Fable 5.1 den Loadbalancer HAProxy von C nach Rust übersetzen. Beide Versionen bestanden fast alle Regressionstests von HAProxy. Opus 5.5 war nach 9,5 Stunden fertig, Fable 5.1 nach 12, und Opus kostete 51 Prozent weniger.
Am meisten überzeugt hat uns ein Test aus der Wissensarbeit. Die Modelle sollten einen Quartalsbericht zu einem Unternehmen schreiben, und ein automatischer Prüfer hat jede Zahl und jedes Zitat gegen die Quellen abgeglichen. Eine einzige erfundene Zahl hieß: durchgefallen. Opus 5.5 kam in 16 von 18 Durchläufen durch, Fable 5.1 und Opus 5 in keinem. Wer unseren Beitrag zu KI-Halluzinationen kennt, weiß, warum wir solche Zahlen wichtiger finden als ein paar Prozentpunkte im Coding-Benchmark. Auch hier gilt allerdings: Den Test hat Anthropic gebaut und ausgewertet.
Endlich lesbarer
Opus 5.5 schreibt verständlicher, und Anthropic gibt offen zu, dass das einer der häufigsten Kritikpunkte an Opus 5 war. Das neue Modell stellt das Wichtigste an den Anfang, verzichtet eher auf Fachjargon und hält sich besser an vorgegebene Schreibregeln. Ein Entwickler bei Ramp nennt ausufernde, schwer lesbare Antworten seinen größten Frust mit Spitzenmodellen und schreibt, Opus 5.5 behebe genau das.
Das klingt nach Kosmetik. Wenn ein Agent aber stundenlang allein arbeitet, muss am Ende ein Mensch nachvollziehen, was er getan hat und warum. Ein Bericht, den man in zwei Minuten versteht, wird gelesen. Einer, der sich über drei Bildschirme zieht, wird überflogen. Anthropic verkauft das als Sicherheitsgewinn, und da stimmen wir zu.
Was sich für Integrationen ändert
Wer Claude über die API in eigene Produkte eingebunden hat, sollte vor dem Umstieg vier Änderungen kennen.
Erstens lässt sich das Denken nicht mehr abschalten. Wie schon Fable 5.1 gibt es Opus 5.5 nur noch mit Thinking-Modus.
Zweitens startet das Modell mit Preserved Thinking, einem Schutz gegen Distillation. Gemeint ist das massenhafte Abgreifen von Modellfähigkeiten über Fake-Accounts. API-Nutzer dürfen den früheren Kontext und das Reasoning von Claude nicht mehr nachträglich bearbeiten. Das gilt für Accounts, die am oder nach dem 31. August 2026 angelegt wurden. Wer in seiner Pipeline den Verlauf umschreibt, sollte das vorher testen.
Drittens leitet Anthropic die meisten reinen Security-Aufgaben an Opus 4.8 weiter. Bugs im eigenen Code finden und beheben geht weiter mit Opus 5.5. Sicherheitsteams können sich für ein Verifizierungsprogramm mit erweitertem Zugang bewerben.
Viertens trägt Opus 5.5 wie Fable 5.1 Wasserzeichen, damit die Ausgaben die Transparenzpflichten des EU AI Act erfüllen. Für Kunden in der EU ist das eher eine gute Nachricht. Man sollte es aber wissen, bevor man generierte Inhalte weiterverarbeitet.
Zero Data Retention bleibt wie bei früheren Opus-Modellen möglich. Verfügbar ist Opus 5.5 ab sofort überall, auch über AWS, Google Cloud und Microsoft Azure. Die Modell-ID auf der Claude-Plattform lautet claude-opus-5-5.
Sicherheit mit ehrlichem Vorbehalt
Im hauseigenen Alignment-Test mit knapp 2.000 Szenarien schneidet Opus 5.5 besser ab als jedes neuere Claude-Modell. Es greift seltener zu Aktionen, die sich schwer rückgängig machen lassen, und hält Prompt Injection besser stand als Opus 5. In einem neuen Test, ob das Modell die Grenzen seiner abgeschotteten Umgebung umgeht, versuchte es das rund 85 Prozent seltener als Opus 5 oder Mythos 5.1. Jeder Versuch war laut Anthropic harmlos, und das Modell hat ihn selbst gemeldet.
Dazu steht in der Ankündigung ein Satz, der hängen bleibt. Anthropic sieht Anzeichen, dass Opus 5.5 oft merkt, wenn es getestet wird. Das macht es schwerer vorherzusagen, wie es sich im echten Einsatz verhält. Dass ein Hersteller das in die Launch-Ankündigung schreibt, rechnen wir ihm an. Nach dem, was METR bei GPT-5.6 Sol gefunden hat, ist es auch keine Randnotiz mehr. Die Prüfverfahren kommen bei allen Anbietern an ihre Grenzen.
Was wir Kunden raten
Rechnet nach, bevor ihr umstellt. Nehmt zwei, drei typische Aufgaben aus eurem Alltag, lasst sie mit Opus 5.5 laufen und vergleicht Ergebnis und Kosten mit dem, was ihr heute nutzt. Wer bisher aus Kostengründen bei Opus 5 geblieben ist, obwohl Fable 5.1 besser gepasst hätte, bekommt jetzt ungefähr beides.
Prüft bestehende API-Integrationen. Pflicht-Thinking und Preserved Thinking können Pipelines brechen, die den Gesprächsverlauf umbauen oder das Denken bisher abgeschaltet haben. Wer vorher testet, merkt das im Staging und nicht in Produktion.
Und behaltet den Reflex, Agenten nur mit engen Rechten und Review auf echte Systeme loszulassen. Ein besseres Alignment-Ergebnis ändert daran nichts, solange niemand sicher sagen kann, ob das Modell sich im Test anders verhält als bei euch.
Fazit
Nach Sonnet 5 im Juni ist Opus 5.5 das zweite Claude-Release in diesem Jahr, bei dem die wichtigste Neuigkeit in der Preisliste steht. Die Spitze wird nicht dramatisch höher, aber deutlich billiger. Aufgaben, bei denen man bisher gezögert hat, weil ein langer Agent-Lauf mit Fable 5.1 richtig Geld kostet, rechnen sich neu. Die Benchmark-Führung ist dagegen Herstellerangabe, und Anthropic sagt selbst, dass man sie nicht überbewerten soll.