Claude Fable 5.2: Mehr Leistung, weniger Fehlalarme
Anthropic veröffentlicht Fable 5.2 und Mythos 5.2. Mehr Leistung bei langen Agent-Läufen und deutlich weniger Fehlalarme. Warum Anthropic trotzdem Opus 5.5 als Standard empfiehlt.
Anthropic hat heute Claude Fable 5.2 und Claude Mythos 5.2 veröffentlicht. Beide Namen stehen für dasselbe Modell. Fable ist die Fassung für alle, mit strengeren Schutzmechanismen bei Cybersicherheit und Biologie. Mythos bekommen nur geprüfte Organisationen. Die Ankündigung steht bei Anthropic.
Bemerkenswert ist ein Satz, der weit oben steht. Für die meisten Aufgaben empfiehlt Anthropic weiterhin Opus 5.5 als Standard. Fable und Mythos seien für die ehrgeizigsten, offenen technischen Aufgaben gedacht. Ein Hersteller, der beim Launch seines Spitzenmodells sagt, dass man es meistens nicht braucht: Das ist ehrlich, und es trifft das, was wir in Projekten sehen.
Die Zahlen
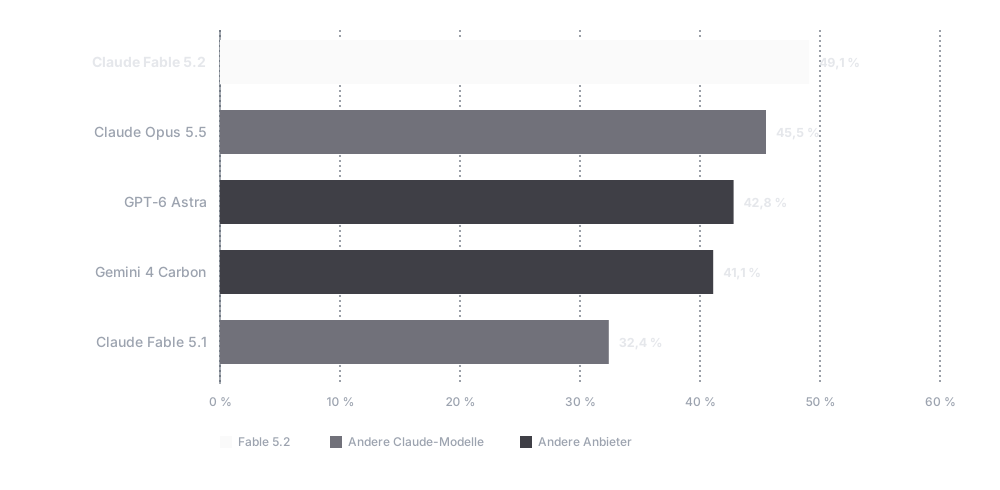
Bei langen, schweren Aufgaben legt Fable 5.2 deutlich zu. Beim Coding-Benchmark FrontierCode 2.0 kommt es mit höchstem Denkaufwand auf 49,1 Prozent. Fable 5.1 lag bei 32,4, Opus 5.5 bei 45,5, GPT-6 Astra bei 42,8. Bei agentischer Forschungsarbeit in der Wissenschaft (Terminal-Bench-Science) steigt der Wert von 52,6 auf 74,6 Prozent. GPT-6 Astra, bisher hier vorn, schafft 68,1.
Interessanter finden wir die Stelle, an der Fable 5.2 nicht gewinnt. Bei Geschäftsabläufen (AutomationBench) liegt Gemini 4 Carbon mit 53,9 Prozent vor Fable 5.2 mit 51,4. Und auf normalem Denkaufwand ist Fable 5.2 bei FrontierCode mit 45,3 Prozent praktisch gleichauf mit Opus 5.5 (45,5), kostet dabei aber laut Anthropic nur etwa die Hälfte pro Aufgabe. Das erklärt die Empfehlung von oben: Der Vorsprung von Fable entsteht erst, wenn man es lange und gründlich arbeiten lässt.
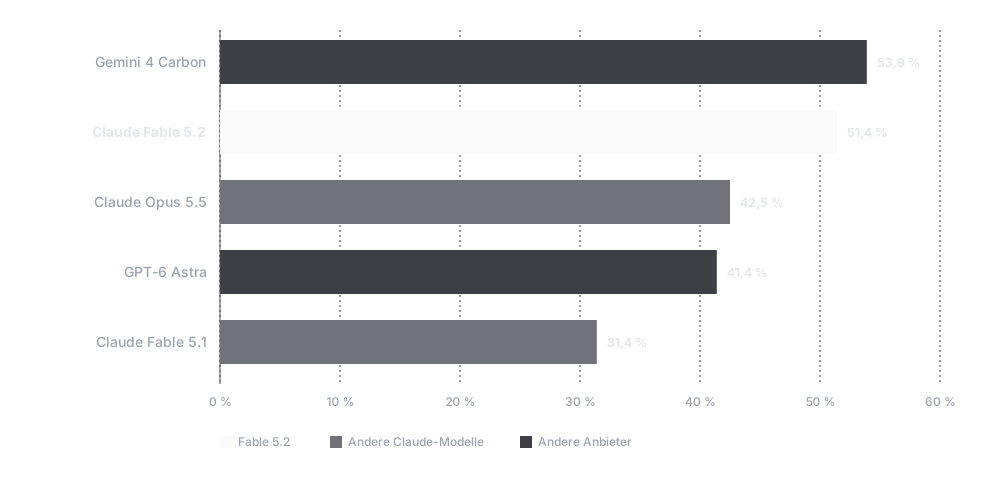
Alle Werte kommen von Anthropic. Nachgemessen hat sie bisher niemand Unabhängiges, und Anthropic hat schon bei Opus 5.5 selbst geschrieben, dass Abstände auf diesem Niveau immer weniger über den echten Einsatz sagen.
Preis und Tempo
Fable 5.2 kostet 8 $ pro 1 Mio. Input-Token und 40 $ pro 1 Mio. Output-Token. Laut Anthropic ist das günstiger als bei 5.1, den alten Preis nennt die Ankündigung aber nicht. Die Ausgabe soll bis zu 30 Prozent schneller laufen. Einen Fast Mode mit bis zu 2,5-facher Geschwindigkeit gibt es in Claude Code, auf der Claude-Plattform, bei Google Cloud und in Microsoft Foundry, zum doppelten Preis von 16 $ und 80 $.
Zum Vergleich: Opus 5.5 kostet 4 $ und 20 $, also die Hälfte. Wer einen Agenten den ganzen Tag laufen lässt, merkt diesen Faktor auf der Rechnung. Abo-Kunden in Pro und Team dürfen Fable für bis zu die Hälfte ihres Wochenlimits nutzen. Zum Start verteilt Anthropic außerdem ein bis drei Fable-Resets, je nachdem, wie lange man schon Kunde ist.
Verfügbar ist Fable 5.2 ab sofort überall, auch über AWS, Google Cloud und Microsoft Azure. Die Modell-ID lautet claude-fable-5-2.
Weniger Fehlalarme
Für alle, die mit Fable 5 und 5.1 programmiert haben, ist das vielleicht die wichtigste Zahl. Fable 5.2 blockiert rund 55 Prozent weniger Anfragen als sein Vorgänger, bei Cybersicherheit etwa 60 Prozent weniger, bei Biologie etwa 40 Prozent. Wir erinnern uns an die Zeit nach der Sperre im Sommer: Der damals verschärfte Filter schlug auch bei ganz normalem Debugging an. Wenn das jetzt seltener passiert, wird Fable im Alltag deutlich angenehmer.
Was weiterhin abgefangen wird, landet bei einem älteren Modell. Cyber-Anfragen beantwortet Opus 4.8, Biologie-Anfragen Opus 5. Wer Fable in eine eigene Anwendung einbindet, sollte diese Weiterleitung kennen, denn die Antwort kommt dann von einem schwächeren Modell.
Mythos 5.2 geht in die andere Richtung. Bei einem internen Test mit 1.829 bekannten Schwachstellen findet es 10,2 Prozent mehr als Opus 5.5. Eine Sicherheitsfirma berichtet, dass jeder sechste bestätigte Fund von Mythos 5.2 von allen anderen getesteten Modellen übersehen wurde. Zugang gibt es über das Cyber Verification Program, Enterprise-Kunden können Claude Security nutzen.
Was die Beispiele zeigen
Ein Team aus 1.000 Fable-Agenten hat die Formalisierung des Großen Fermatschen Satzes in 30 Stunden abgeschlossen. Die erste Formalisierung dauerte 11 Tage, Opus 5.5 kam mit demselben Aufbau nach 18 Stunden auf 26 Prozent. Ein anderes Team hat einen Produktionsdienst von Python nach Rust übertragen, der jetzt etwa 26-mal schneller startet. Laut Anthropic stammen inzwischen über 90 Prozent der Änderungen im eigenen Kerncode von Claude.
Neu ist auch, wie Anthropic Fable einsetzen will: als Berater oder Dirigent für andere Modelle. Das passt zum Preis. Fable plant und prüft, die günstigeren Modelle erledigen die Masse der Arbeit. In vielen agentischen Setups dürfte genau diese Aufteilung am meisten bringen.
Zwei Punkte, die man kennen sollte
Erstens die Daten. Ohne die neuen Enterprise Frontier Safeguards speichert Anthropic Anfragen an Fable und Mythos 30 Tage lang zur Sicherheitsüberwachung. Diese Safeguards laufen in der eigenen Infrastruktur des Kunden und vertragen sich mit Zero Data Retention, sind aber noch in einer geschlossenen Beta. Berechtigte Enterprise-Kunden können Fable 5.2 schon vorher mit Zero Data Retention nutzen. Für Kunden in der EU mit sensiblen Daten ist das die erste Frage, die vor einem Einsatz geklärt sein muss.
Zweitens eine bewusste Grenze. Anthropic hat die Fähigkeiten, die die KI-Entwicklung selbst am direktesten beschleunigen würden, beim Training gedrosselt. Bei der Optimierung von Rechenkernen für KI-Chips und beim Entwurf von Sprachmodell-Architekturen liegt Fable 5.2 nur auf Opus-5.5-Niveau. Coding, Hardware-Entwicklung und allgemeine Forschung sollen nicht betroffen sein. Dass ein Hersteller sein Spitzenmodell an einer Stelle absichtlich schwächer macht, haben wir so noch nicht gelesen.
Sicherheit mit bekanntem Vorbehalt
Im hauseigenen Verhaltenstest schneidet Mythos 5.2 besser ab als Opus 5.5 und Mythos 5.1. Bei der Frage, ob das Modell aus seiner abgeschotteten Umgebung ausbricht, sind die Werte stark gesunken: Mythos 5 nutzte in 39 Prozent der Szenarien Zugangsdaten, die es nicht hätte nutzen sollen, Mythos 5.1 in 21 Prozent, Mythos 5.2 noch in 3,1 Prozent. Geprüft haben unter anderem das britische AI Security Institute und METR.
Den Vorbehalt kennen wir schon von Opus 5.5. Auch die neuen Modelle äußern häufiger den Verdacht, gerade getestet zu werden. Je öfter ein Modell das merkt, desto weniger sagen die Tests über den echten Einsatz.
Was wir Kunden raten
Bleibt beim Standard. Für Chat, Texte, die meisten Coding-Aufgaben und normale Automatisierungen reicht Opus 5.5, und es kostet die Hälfte. Fable 5.2 lohnt sich dort, wo ein Agent stundenlang allein an einem schweren Problem arbeitet und ein Fehlschlag teurer ist als die Token.
Wer Fable schon einsetzt und sich über die Fehlalarme geärgert hat, sollte 5.2 mit den Anfragen testen, die bisher hängen geblieben sind. Der Preis sinkt beim Wechsel ohnehin. Und wer personenbezogene Daten verarbeitet, klärt vorher, ob die 30 Tage Aufbewahrung zu den eigenen Vorgaben passen.
Fazit
Fable 5.2 ist ein großer Schritt bei genau den Aufgaben, für die man ein Modell dieser Klasse braucht: lange Agent-Läufe und schweres Coding. Für den Alltag bleibt es zu teuer, und Anthropic sagt das selbst. Für die meisten Nutzer zählt deshalb eine andere Zahl mehr als jeder Benchmark: 55 Prozent weniger Anfragen, die grundlos hängen bleiben.
Newsletter
Neue Beiträge per Mail
Wir schreiben dir, wenn im Newsroom etwas Neues erscheint.
Du bekommst gleich eine Mail mit einem Link. Erst damit ist deine Anmeldung abgeschlossen. Abmelden kannst du dich jederzeit. Datenschutzerklärung